「ローカルLLM」「オンプレLLM」という言葉を耳にする機会が増えました。生成AIを使いたいけれど、情報セキュリティの観点から導入をためらっている学校・企業・士業の方も多いのではないでしょうか。この記事では、ローカルLLMの基本的な仕組みと、クラウドの生成AIとの違い、導入すべきかどうかの判断基準を整理します。
ローカルLLMとは
LLM(Large Language Model、大規模言語モデル)は、ChatGPTやGeminiなど、生成AIの中核となる技術です。通常、私たちがChatGPTなどを使うときは、インターネットを通じて事業者のサーバーにあるLLMにアクセスし、処理結果を受け取っています。これがいわゆる「クラウド型」の生成AIです。
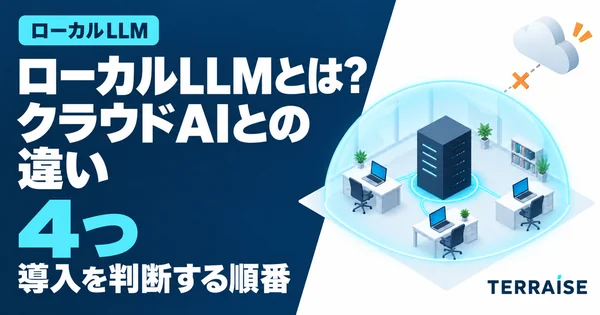
一方「ローカルLLM」は、このLLMを組織内のサーバーやパソコンに置き、インターネットを介さずに動かす方式を指します。「オンプレLLM」「オンプレミス環境の生成AI」とほぼ同じ意味で使われます。入力した情報が外部のサーバーに送信されないことが、最大の特徴です。

クラウドAI(クラウドLLM)とローカルLLMの違い
| 観点 | クラウドAI | ローカルLLM |
|---|---|---|
| 情報の送信先 | 事業者のサーバー(インターネット経由) | 組織内のサーバー・PC(外部に送信されない) |
| 性能 | 最新・最大規模のモデルを利用しやすい | ハードウェアの制約を受ける |
| 導入のしやすさ | すぐに使い始められる | ハードウェアの選定・構築が必要 |
| 運用コスト | 利用量に応じた従量課金が中心 | 初期の構築費用が中心 |
| 向いている用途 | 公開情報・一般的な業務 | 個人情報・機密情報を扱う業務 |
ローカルLLMが必要になる場面
すべての組織にローカルLLMが必要なわけではありません。次のような場合に、選択肢として検討する価値があります。
- 個人情報・機密情報を含むデータを、生成AIに読み込ませて活用したい
- 業界のガイドラインや社内規程で、外部への情報送信が制限されている
- 学校・自治体など、生徒や住民の情報を扱う立場で、外部サービスへの依存を避けたい
- 情報システム部門から、クラウドサービスの利用許可が下りない
逆に、公開情報や一般的な業務文書が中心であれば、クラウドの生成AIのほうが手軽で、最新かつ高性能なモデルを使い続けられるという利点があります。無理にローカルLLMを導入する必要はありません。
導入の判断基準
ローカルLLMを検討する際は、次の順番で整理することをおすすめします。
- 扱う情報を洗い出す — どの業務が、どんな情報を扱っているか
- 外部送信の可否を確認する — 規程・ガイドライン上、外部のクラウドサービスに送ってよい情報かどうか
- 業務ごとに使い分ける — 公開情報が中心の業務はクラウドAI、機密情報を扱う業務はローカルLLM、というように使い分ける
- 運用体制を確認する — ハードウェアの管理・更新を誰が担うか
すべての業務をローカルLLMに統一する必要はなく、情報の性質に応じて使い分けるのが現実的です。

実際の導入例
惺山高等学校(山形県)では、生徒の学習データや校内文書など、外部に出しにくい情報を扱いながら生成AIを授業・校務に活用するため、NVIDIA DGX Sparkとオープンモデルを使ったローカルLLM環境を、サードウェーブと共同で構築しました。ネットを介さない校内専用のAI環境として、日本初の高校内ローカルLLM導入と報じられています(ICT教育ニュース・こどもとIT・EdTechZineなど)。
導入にかかる費用について
ローカルLLM導入の費用は、ハードウェアの規模や要件定義の範囲によって変わります。要件定義から構築、運用設計、使い方の研修まで含めて、初回相談(60分・無料)で状況をうかがい、個別にお見積りします。
まとめ
ローカルLLMは「クラウドAIより優れている」技術ではなく、扱う情報の機密度に応じて選ぶべき「もう1つの選択肢」です。まずは自社・自校が扱う情報を洗い出し、外部に出せる情報とそうでない情報を整理するところから始めてみてください。
Supervised by — 監修
株式会社TERRAISE 代表取締役CEO 舟橋 遼亮2025年2月に株式会社TERRAISEを創業。お茶の水女子大学 外部講師、Google AI Student Ambassador(2025年)を務める。上場企業や全国の高校などで、AIの活用を実際に指導している。